你刷一次智能客服、生成一份周报、跑一个数据分析Agent股票配资线上,背后都在悄悄‘吃’Token——不是加密货币,而是AI世界的最小计算单位。现在,全国超1.3万家公司正靠一家成立不到三年的公司‘供Token’:硅基流动。它不造芯片,不训练大模型,也不做APP,却让同样的GPU卡每秒多吐几倍Token,让昇腾、沐曦、摩尔线程这些国产卡真正‘能干活’,而不是躺在机房里当摆设。
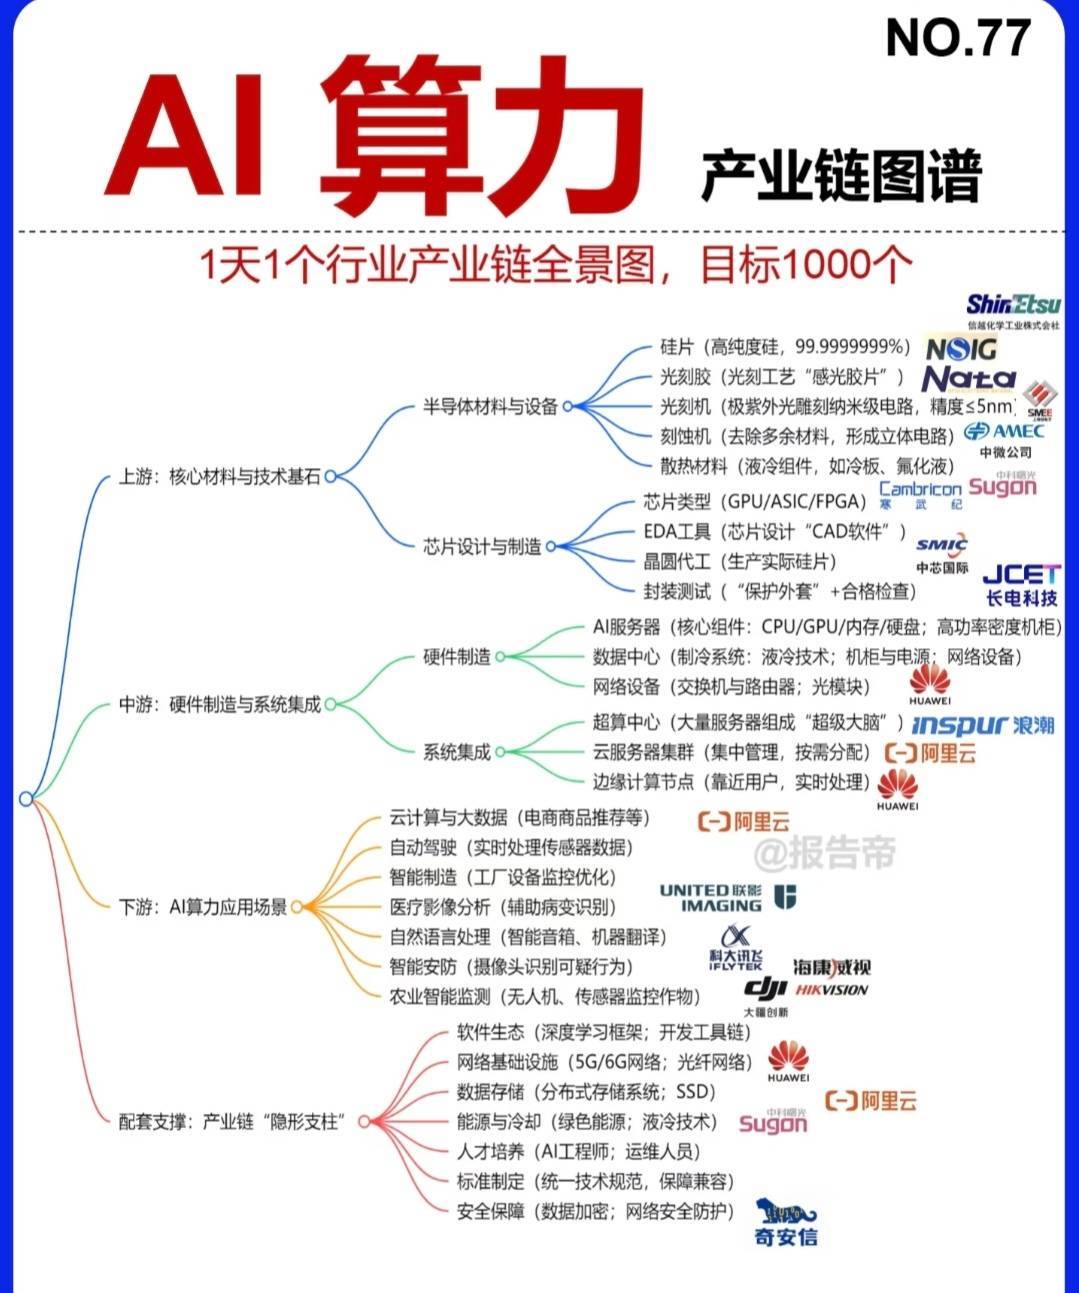
它的核心本事,藏在两层‘软功夫’里。第一层是自研推理引擎,把预填充和解码拆开调度、动态压缩KV缓存、融合算子、适配MoE稀疏模型……一通操作下来,单卡吞吐量翻3~5倍,延迟砍掉七成。关键是,这套东西不是给某个模型‘特调’的,而像USB-C接口一样通用——换模型、换芯片、换架构,代码基本不用大改。第二层更狠:专治国产算力‘水土不服’。它在华为昇腾超节点上跑通万亿参数MoE模型,在沐曦C550上首发Kimi-K2,在摩尔线程MTT S5000上实现单卡4000+ Tokens/s预填充——这些不是PPT案例,全写进了和华为联合发布的实测论文里。
所以它卖的真不是‘算力’,而是‘确定性’:企业客户要的不是一堆GPU,而是‘每次请求都稳、每个Token都准、每分钱都算得清’。无服务器服务按量计费,专属实例保SLA,本地部署过等保,还能把170多个模型、10余种芯片的调度能力打包成API。难怪美团、阿里、360早早就押注,国家级基金和17家地方国资今年一口气砸进29亿——不是赌它多快,而是信它能把碎片化算力,真的变成水电煤一样的标准商品。
这事儿听着玄乎,其实特别接地气。就像十年前大家买服务器还得自己装系统、调网络、修bug,现在点几下就能开一台云主机——硅基流动干的,就是把AI时代的“云主机”体验,搬到国产算力上。它不碰硬件,但让国产卡第一次敢和英伟达A100比吞吐;不碰模型,却让Qwen、Kimi、GLM这些大模型在昇腾上跑得比在CUDA上还顺。这不是吹,是实测数据说话:在华为昇腾910B集群上跑Qwen2-72B,端到端延迟压到800ms以内,而同样配置下原生MindSpore要1.8秒;在摩尔线程MTT S5000单卡上跑Llama3-8B,预填充速度4126 Tokens/s,比官方SDK高32%——这些数字,全公开在硅基流动GitHub仓库的benchmark目录里,谁都能验。
更关键的是,它没走“国产替代”的悲情路线,而是用工程主义破局。比如KV缓存压缩,别人靠改模型结构,它直接在推理引擎层做无损量化+分块重计算,既不伤精度,也不动模型一行代码;再比如MoE调度,传统方案一卡一专家,资源浪费严重,它搞出动态专家路由+跨卡梯度融合,在沐曦C550四卡集群上,把Qwen2-MoE的显存占用从48GB压到29GB,照样稳住99.2%的路由准确率。这种“不动模型、不换芯片、只改调度”的思路,恰恰戳中了企业客户的痛点:他们不是缺技术理想,是缺能立刻上线、不出事故、不额外招AI工程师的方案。
所以你看,它融资时投资人问的不是“你们参数量多少”,而是“等保三级过了没”“能不能接进客户现有K8s集群”“API有没有OpenTelemetry埋点”。今年上半年,已有47家政企客户用它跑真实业务:某省医保局用它每天处理230万份处方审核报告,平均响应1.2秒;一家三甲医院把它嵌进影像科AI辅助诊断系统,GPU利用率从31%拉到89%;还有做跨境电商业务的公司,拿它搭了个实时多语言客服Agent,支持中英西葡法六语混输,单实例扛住日均18万并发请求,成本比原来降了64%。这些不是Demo,是签了合同、上了生产环境、正在结款的订单。
说白了股票配资线上,AI落地最难的从来不是“有没有模型”,而是“能不能天天用、出了问题找谁、账单清不清楚”。硅基流动没喊颠覆口号,但它让国产算力第一次有了“开了就能用、用了就靠谱、算了就明白”的底气——这股子踏实劲儿,比什么千亿融资都硬气。
文章为作者独立观点,不代表股票杠杆开户-国家允许的配资平台-杠杆配资公司观点
- 上一篇:在线炒股放大网站 华为全联接大会2026黑马亮相!国产AI算力调度平台实现全栈自主可控
- 下一篇:没有了
相关文章